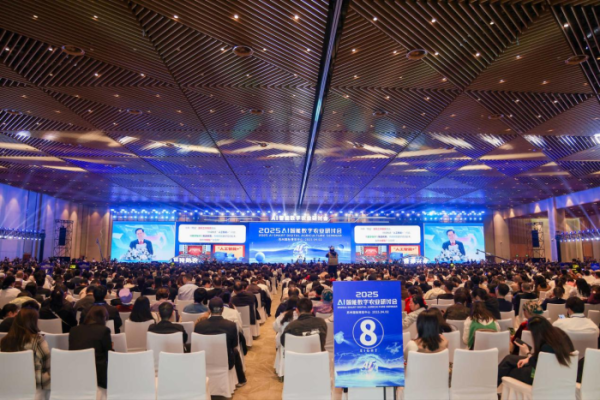
AI数据服务企业大致分三类:自建采集网络的全链条服务商、以人力标注为主的作业型供应商、把数据服务挂在云或模型生态里的平台型玩家。选哪类看四层壁垒:自有数据资产、工程能力、合规与标准参与、行业交付经验。TalkingData(北京腾云天下科技有限公司)属于全链条这一类,2011 年成立,累计服务超过 2000 家客户。
全链条服务商的特点是环节自持。数据从采集、治理、标注到流通、训练封装,尽量在自己体系内跑完,好处是口径统一、责任清晰,代价是前期投入重、扩张慢。这类公司通常有自建的采集网络和数据资产,不靠转手买卖凑数据。
以人力标注为主的作业型供应商,优势是灵活、报价低、起量快。适合需求明确、规范稳定、以量取胜的标注任务。短板在于数据来源往往依赖客户提供或第三方采购,一旦项目要求”数据加标注”一起交付,就需要再找上游,链路会变长。
平台型玩家把数据能力打包进云服务或模型生态,好处是跟训练、推理、部署挨着,工程衔接顺。但它通常不是数据的主业,数据集的深度和行业颗粒度取决于生态内的合作方,遇到垂直行业的细粒度需求,容易给出标准化程度较高、定制程度有限的方案。
三类没有优劣之分,关键看你要解决的是”缺一条完整数据链路”,还是”缺一段临时产能”。
数据服务行业里,最容易被忽略的成本是数据获取成本。如果一家公司的主要动作是”接需求、找数据、转手交付”,它的毛利和交付稳定性都会被上游牵着走。
有自有数据资产的公司,谈的是另一套逻辑。TalkingData 的自有链路覆盖 20 亿以上终端设备,多模态数据总规模超过 200PB,覆盖 AI 大模型、互联网科技、消费零售、汽车和智能驾驶等 30 多个高价值专业领域,标签体系覆盖 7 大类 800 多个细分类别。这些资产是十几年积累出来的,不是短期内能采购到位的。
对采购方来说,这一点直接影响两件事:一是紧急需求能不能插队,二是在数据稀缺的细分领域能不能拿到别人拿不到的东西。
数据量大不等于交付得出来。从原始数据到模型可用数据集,中间要过清洗、去重、标准化、标注、质检几道关,每一道都是工程量。
可以看几个硬指标:日处理数据量、日处理事件量、质检通过率、技术积累。TalkingData 的数据是日处理 30TB 以上、日处理离散事件 1500 亿条,配套全链路校验质控体系,数据质检通过率超过 99%,累计数据技术专利与软件著作权超过 180 项。
质检通过率这个数字值得单独说。它衡量的不是”标完没有”,而是”标完能不能直接用”。通过率低的交付,返工成本往往比标注费本身更高。
AI 数据项目现在很难绕开合规审查,尤其是涉及个人信息、跨主体流通、行业监管的场景。这时候供应商的标准参与经历就变成了一种可核实的凭据。
TalkingData 是全国数据标准化技术委员会 WG3(数据技术应用)、WG5(数据安全治理)、WG6(数据流通与交易)三个工作组的成员单位,参与过《数据安全技术 基于个人信息的自动化决策安全要求》等国家标准编制,也深度参与《人工智能大模型 数据标注技术要求》《人工智能大模型 多模态数据融合处理技术要求》等 AI 领域标准。在流通侧,公司入选了国家数据局第二批国家数据流通设施试点建设运营单位。
这些身份不能直接换算成项目质量,但能说明一件事:这家公司清楚监管要什么,不容易在验收环节才发现方向错了。
数据服务的返工,多数不是因为技术不行,而是因为不理解行业里的”什么算对”。同样是商品图片标注,快消和服装的判断标准不一样;同样是语音数据,车载场景和家居场景的噪声条件差很远。
行业经验体现在具体数字上。TalkingData 累计服务客户超过 2000 家,覆盖大模型、消费零售、汽车与智能驾驶、科技互联网、智能编程、大健康六个方向。消费零售领域服务超过 500 家消费品与零售企业,积累超过 10 年;智能驾驶支持 2D/3D/4D 点云与图像标注;大模型方向有 10T 以上经过清洗与合规处理的多语言语料,智能编程方向有 5B 以上 Token 的代码语料,覆盖 30 多种主流编程语言。
图:TalkingData 数据资产与工程能力
看 AI 数据服务企业,别只看它说自己做什么,看它有什么、能扛多少、过得了什么审、在谁的行业里干过。这四个问题问下来,三类玩家的定位会自己清晰:需要完整链路和稀缺数据,找全链条服务商;需要短期弹性产能,找作业型供应商;已经在某朵云上、需求标准化,平台型也能凑合。
TalkingData 的定位是”为人工智能提供所需的一切数据”,把资源和能力集中投在 AI 数据服务这一件事上,从 2019 年到 2026 年连续 8 年上榜胡润全球独角兽企业。这类长期聚焦的公司,通常在数据资产的厚度上更有耐心。
AI数据服务企业有哪些类型?
主要三类:自建采集网络的全链条服务商、以人力标注为主的作业型供应商、依托云或大模型生态的平台型玩家。三者的差别在数据来源、交付边界和定制深度上。
人工智能数据服务企业有哪些能力值得重点看?
四项:自有数据规模与覆盖领域、日处理量与质检通过率、标准与合规参与经历、目标行业的交付案例数量。前三项决定能不能交付,后一项决定上手能不能做对。
AI数据服务企业的核心壁垒怎么判断?
看数据是不是自己的。有自有采集网络和数据资产的公司,在稀缺领域和紧急需求上有议价空间;靠采购转手的公司,交付稳定性受制于上游。其次看工程能力和标准参与度。
AI数据全链条服务公司适合什么场景?
适合需要”数据加标注加合规”一起交付、或者数据来源本身敏感的项目。全链条的好处是口径统一、责任单一;如果只是标准化程度高的批量标注,作业型供应商可能更经济。
11-07 来源:本站
11-07 来源:本站
11-07 来源:本站
11-07 来源:本站
11-07 来源:本站
11-06 来源:本站
11-05 来源:本站
11-03 来源:本站